

 开发指南
考勤日报生成:按天统计与多维度数据分析
概述
本方案提供一套完整的员工考勤报表数据获取与汇总解决方案,通过钉钉开放平台的考勤报表API,实现按天粒度的指标数据采集与本地聚合计算。方案背景
企业在日常运营管理中,需要定期统计和分析员工的考勤数据,如应出勤天数、实际出勤天数、迟到次数、早退次数、缺勤次数等关键指标。钉钉管理后台提供了可视化的考勤报表功能,但企业自有系统(如HR系统、BI平台、OA看板)需要通过API自动化获取这些数据,用于:- 自动化报表生成:定时导出月度/季度/年度考勤汇总报表,替代人工手动操作。
- 跨系统集成:将考勤数据同步至企业ERP、薪酬计算系统,实现数据闭环。
- 深度数据分析:结合业务数据(如销售额、客户满意度)进行多维度关联分析。
- 异常监控告警:实时监测部门/个人的考勤异常趋势,提前预警风险。
- 理解门槛高:初次接入的开发者容易误解接口能力,期望直接获取月度汇总结果。
- 开发成本高:需编写额外的数据聚合逻辑,处理日期范围遍历、空值填充、异常过滤等复杂场景。
- 性能挑战:大规模企业(千人以上)按月查询时,需调用数千次接口,易触发限流或超时。
核心价值
本方案提供一套完整的员工考勤报表数据获取与汇总解决方案,通过标准化接口调用流程与最佳实践,帮助企业高效实现考勤数据的自动化采集与分析。- 标准化接入流程:明确4步核心API调用顺序(智能统计确认→列定义获取→列值查询→数据汇总),降低理解成本。
- 灵活的数据粒度:支持按天、按人、按部门、按考勤组等多维度查询,满足不同业务场景需求。
- 高性能批量处理:提供分页查询、并发控制、缓存策略等优化手段,确保大规模数据获取的稳定性。
- 完整的数据校验:内置数据一致性检查机制,自动识别缺失日期、重复记录、异常值等问题。
适用场景
本方案适用于以下典型业务场景:- HR月度报表自动化:每月1号自动生成上月全公司考勤汇总表,发送至管理层邮箱。
- 薪酬计算系统集成:将考勤数据(迟到扣款、加班时长)同步至薪酬系统,自动计算工资。
- 部门绩效看板:实时展示各部门出勤率、迟到率排名,辅助管理决策。
- 个人考勤查询应用:员工自助查询历史考勤明细,减少HR咨询工作量。
典型业务场景
场景一:HR月度考勤报表自动化生成
痛点分析
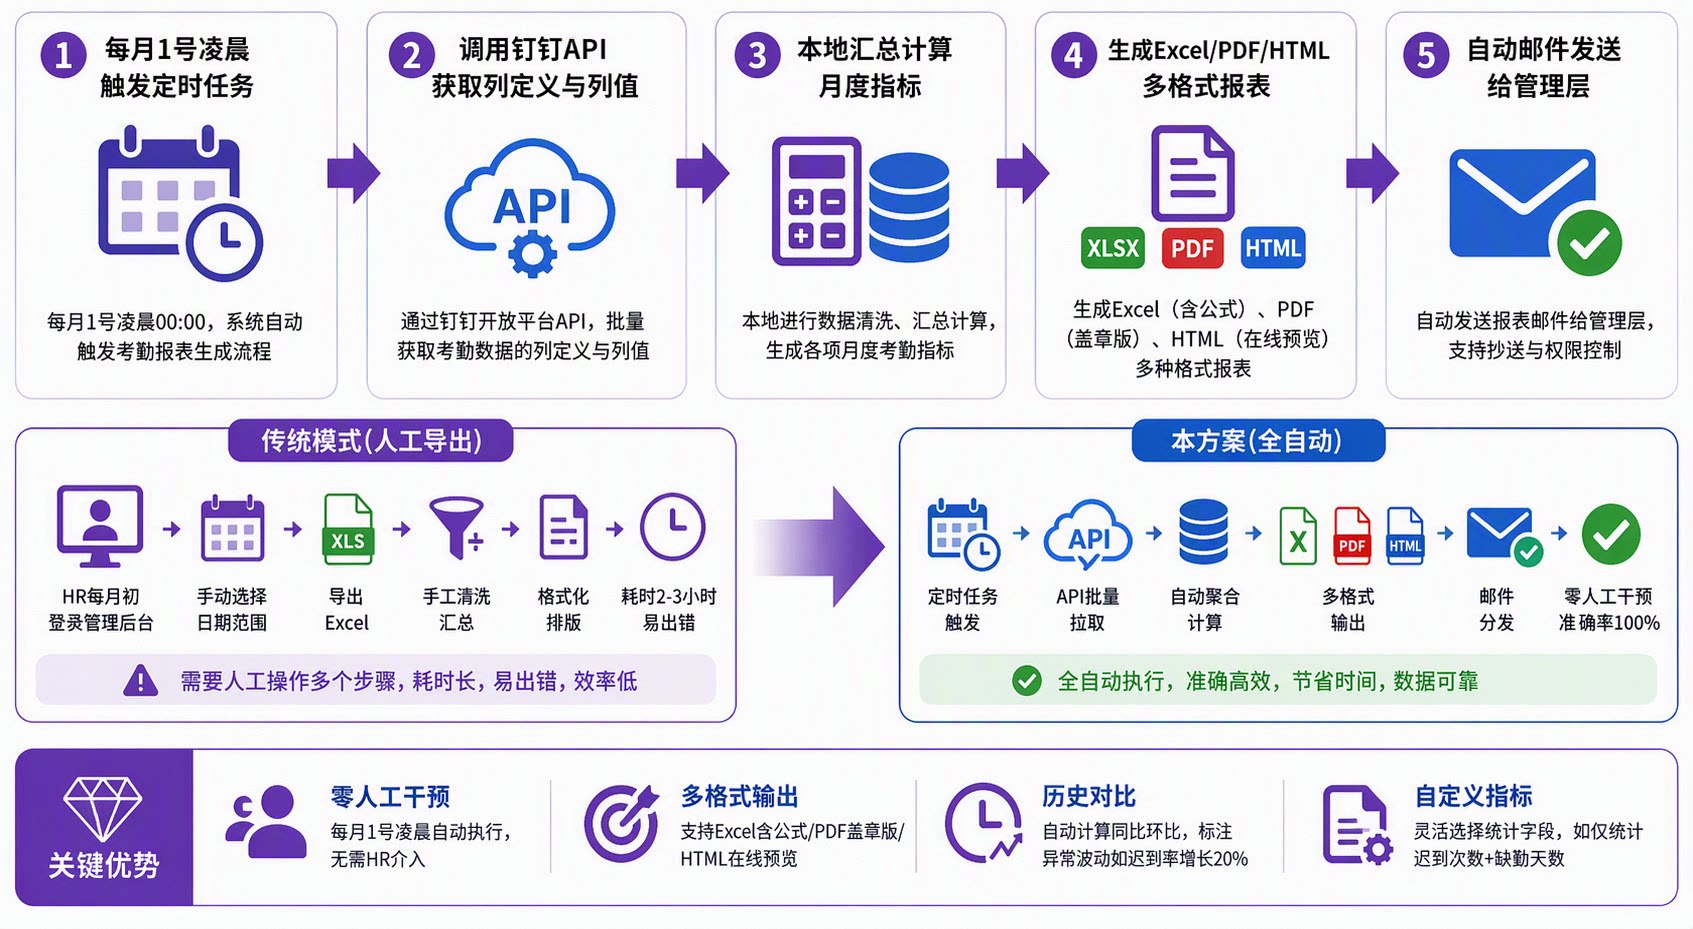
传统模式下,HR每月初需登录钉钉管理后台,手动导出上月全公司考勤报表,再使用Excel进行数据清洗、汇总、格式化,耗时2-3小时且容易出错。当企业规模扩大至千人以上时,手工操作几乎不可行。价值验证
-
自动化流程
-
关键优势
- 全自动生成:每月1号凌晨自动执行脚本,生成Excel/PDF报表并邮件发送给指定人员,零人工干预。
- 多格式输出:支持Excel(含公式)、PDF(盖章版)、HTML(在线预览)等多种格式,满足不同分发需求。
- 自定义指标:可根据企业需求灵活选择统计指标(如仅统计”迟到次数+缺勤天数”,忽略其他字段)。
- 历史对比:自动计算同比/环比数据,标注异常波动(如某部门迟到率较上月增长20%)。
场景二:薪酬系统考勤数据同步
痛点分析
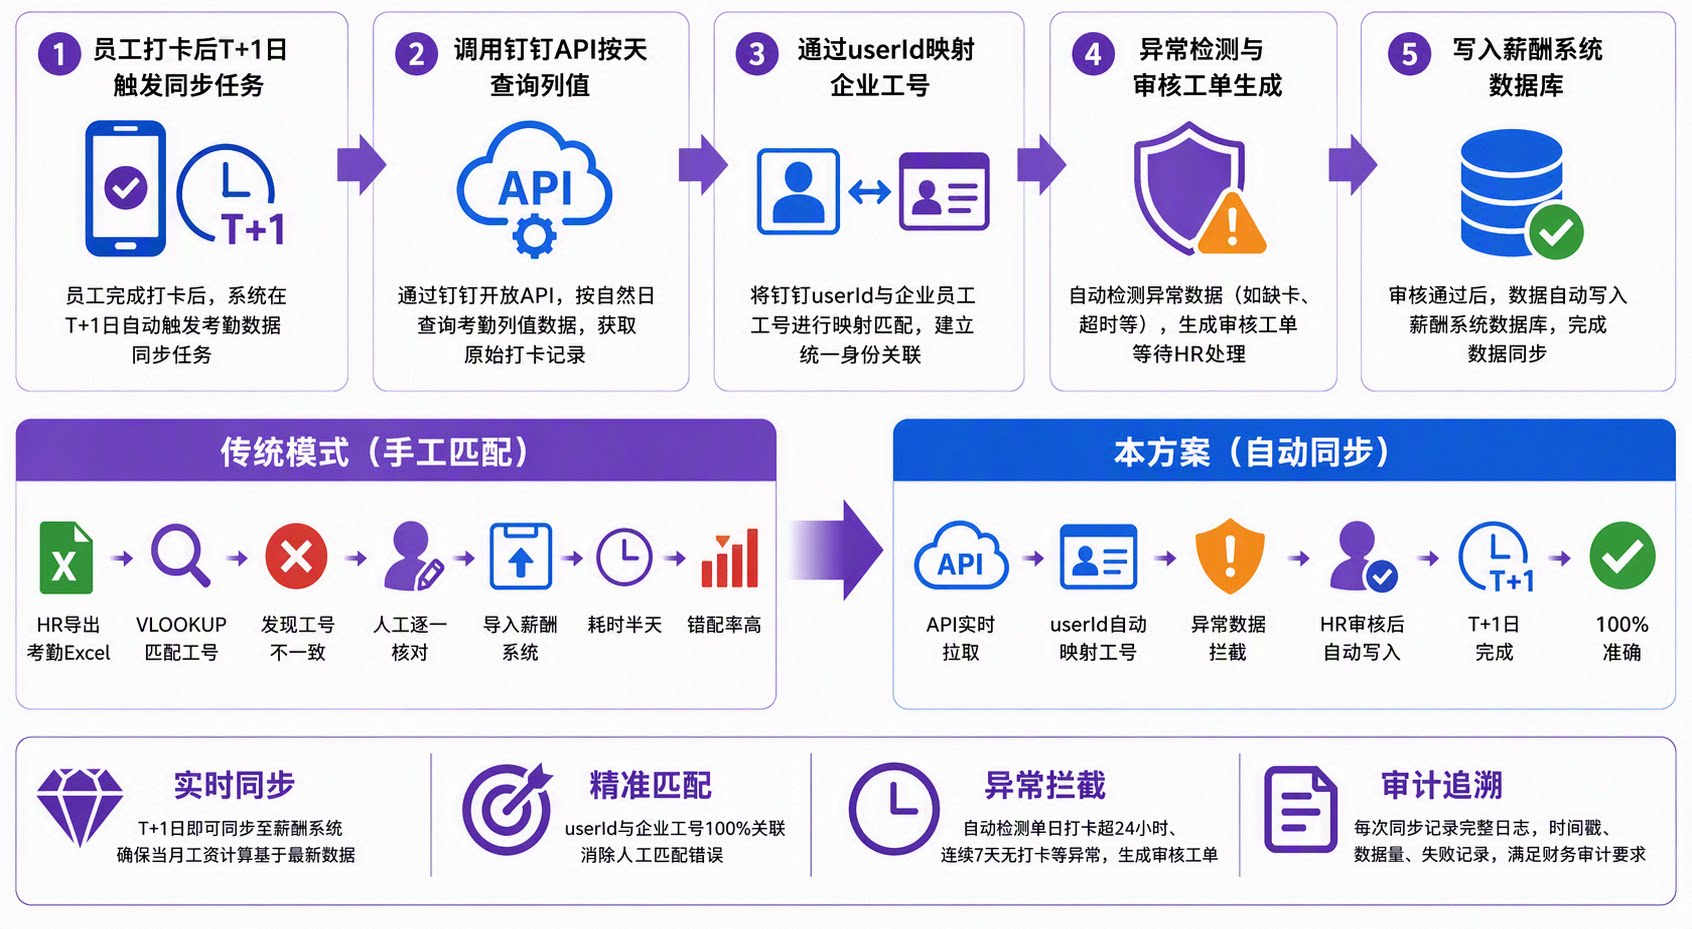
薪酬计算依赖准确的考勤数据(如迟到扣款金额、加班费基数),但钉钉与薪酬系统之间缺乏标准数据接口,HR需每月手动导出考勤明细,再通过Excel VLOOKUP匹配员工工号,最后导入薪酬系统。此过程不仅耗时,还容易因工号不一致导致数据错配。价值验证
-
自动化流程
-
关键优势
- 实时同步:员工打卡后T+1日即可同步至薪酬系统,确保当月工资计算基于最新数据。
- 精准匹配:通过钉钉userId与企业工号的映射关系表,实现100%准确的数据关联,消除人工匹配错误。
- 异常拦截:自动检测异常数据(如单日打卡超过24小时、连续7天无打卡记录),生成审核工单供HR确认后再同步。
- 审计追溯:每次同步记录完整日志(时间戳、数据量、失败记录),满足财务审计要求。
实施指南
技术架构
本方案基于钉钉开放平台的服务端API构建,核心技术组件包括:- 身份鉴权层:通过
Client ID/Client Secret获取access_token,确保接口调用安全性。 - 智能统计确认层:调用接口确认企业是否已开启智能统计功能,避免后续接口调用失败。
- 列定义管理层:获取考勤报表所有可用列的ID与名称,作为后续查询的基础元数据。
- 列值查询引擎:根据列ID、用户ID、日期范围,逐日查询具体指标值,支持分页与批量处理。
- 数据汇总与校验层:对按天粒度的原始数据进行聚合计算(求和、平均、计数),并执行数据一致性检查。
前置条件
在实施方案前,需满足以下条件:- 应用准备:完成企业内部应用的创建与配置,参考应用创建与配置。
- 权限要求:拥有钉钉企业管理员或子管理员权限。
- 开发环境:已安装Java开发环境(JDK1.6及以上)及Maven构建工具。
- SDK准备:下载钉钉服务端SDK,详情参见服务端SDK下载,支持Java/Python/Go等多语言。
- 智能统计开启:确认企业考勤打卡应用已开启智能统计能力(旧版UI可能未开启,需调用接口确认)。
代码实现
-
步骤一:获取应用凭证信息,获取应用 Client ID 和 Client Secret。
步骤二:获取应用访问凭证获取企业内部应用的access_token。调用接口时,通过accessToken鉴权调用者身份。
步骤三:调用考勤相关API:
- 调用服务端API-查询是否启用智能统计报表接口,确认是否已经开启智能统计。
- 调用服务端API-获取考勤报表列定义接口,获取考勤报表列
ID。 - 根据考勤报表列
ID,调用服务端API-获取考勤报表列值接口,实现获取列定义对应的值的信息。 - 对按天粒度的原始数据进行本地汇总计算,生成月度/季度/年度报表。
实施步骤
步骤一:获取应用凭证
- 登录钉钉开发者后台。
- 选择目标应用,进入应用详情页。
- 单击基础信息 > 凭证与基础信息。
- 记录应用的
Client ID和Client Secret。
说明
请妥善保管Client Secret,不要泄露给第三方。建议将其存储在环境变量或密钥管理系统中,避免硬编码在代码里。
步骤二:获取访问凭证(access_token)
根据步骤一中 的 Client ID 和 Client Secret,获取应用访问凭证获取企业内部应用的access_token。- 缓存策略:
access_token有效期为2小时,建议在内存或Redis中缓存,过期前5分钟主动刷新。 - 并发控制:避免多个线程同时刷新token导致冲突,可使用分布式锁机制。
- 异常重试:网络波动时自动重试,最多3次,间隔递增(1s → 2s → 4s)。
步骤三:核心API调用
- 查询是否启用智能统计报表:调用服务端API-查询是否启用智能统计报表接口,确认企业是否已开启智能统计功能。
说明
目前考勤打卡应用已经开启智能统计能力,但由于存在旧版UI可能未开启智能统计,调用此接口可避免因功能未开启导致的后续接口调用失败。- 获取考勤报表列定义:调用服务端API-获取考勤报表列定义接口,获取考勤报表所有可用列的ID与名称。
说明
获取列定义不包含请假信息,如需获取报表内的请假统计信息,调用获取报表假期数据接口即可。-
获取考勤报表列值(按天粒度):根据考勤报表列ID、用户ID、日期,调用服务端API-获取考勤报表列值接口,实现获取列定义对应的值的信息。
-
数据汇总与校验:对按天粒度的原始数据进行本地汇总计算,生成月度/季度/年度报表。
- ✅ 智能统计功能已确认开启。
- ✅ 成功获取所有可用列ID列表。
- ✅ 按天查询列值接口调用正常,能返回有效数据。
- ✅ 本地汇总逻辑测试通过,结果与钉钉管理后台一致。
- ✅ 异常数据处理完善(缺失日期填充0、重复记录去重)。
常见问题(FAQ)
-
Q1:为什么不能直接获取月度汇总表?
A:钉钉开放平台的设计是提供原子化数据能力,而非预定义的汇总报表。原因包括:
- 灵活性:不同企业对”月度汇总”的定义不同(如有的按自然月,有的按考勤周期),开放接口让开发者自定义汇总逻辑。
- 性能考量:直接返回千人级企业的月度汇总表可能导致响应超时,按天粒度查询更易实现分页与缓存。
- 数据新鲜度:按天查询可实时获取最新数据,而月度汇总表通常T+1日才更新。 建议:在本地建立数据仓库,定时同步按天数据并预计算常用汇总指标,平衡实时性与性能。
-
Q2:如何高效查询千人级企业的月度数据?
A:推荐采用以下优化策略:
- 分批并行:将员工列表分为10-20个批次,每批50-100人,使用线程池并行查询。
- 日期范围压缩:若仅需工作日数据,先过滤掉周末与节假日,减少30%-40%的无效查询。
- 缓存命中:对同一日期范围内的相同列ID查询结果进行缓存,避免重复调用。
- 增量同步:首次全量同步后,每日仅同步新增/变更的数据,大幅降低日常维护成本。
-
Q3:如何处理员工中途入职/离职导致的日期不完整问题?
A:考勤报表接口会自动根据员工的实际在职日期返回数据:
- 入职前日期:返回空值或0,需在本地逻辑中跳过这些日期。
- 离职后日期:同样返回空值或0。
-
Q4:列ID是否会变化?是否需要定期重新获取?
A:列ID在企业开通智能统计后基本稳定,但以下情况可能发生变化:
- 钉钉版本升级:新增统计指标时会增加新列ID。
- 企业自定义字段:若企业配置了自定义考勤规则,可能生成专属列ID。
- 建议:每周或每月重新调用一次”获取列定义”接口,更新本地列ID映射表,确保兼容性。